개요
일반적으로 처음에 K8S와 Docker 그리고 VMware등을 배울때 기본적인 차이점을 학습하곤 합니다.
사실 그리 어려운 개념이 아니라고 생각이 들기 때문에 아래와 같은 사진을 많이 보았으리라 생각합니다.
구글에 가볍게 'docker vs vm' 이라고만 검색해도 이렇게 비슷한 사진들이 많이 나옵니다.
그 중 제일 많이 보았을 사진인 아래 사진을 보도록 해보겠습니다.
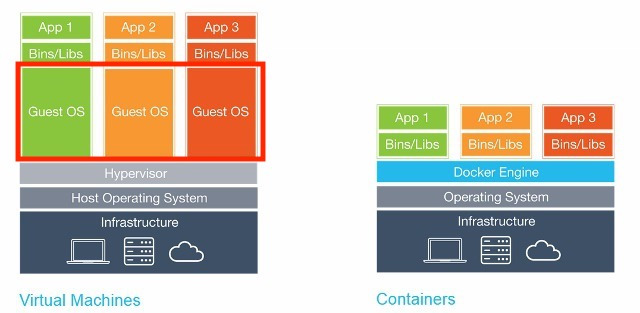
대부분 이 그림을 보고 "VM은 Hypervisor 위에서 가상화되고, Docker는 OS 위에서 가상화된다"고 이해하곤 합니다.
(사실 저도 처음 이해할때는 그랬습니다.)
그런데 이 그림에는 한 가지 함정이 있습니다. VM 쪽에는 Guest OS, 즉 VM마다 자기 커널이 따로 있다는 사실은 모두가 알 겁니다.
반면 컨테이너 쪽에는 Guest OS가 없기에 컨테이너들은 호스트의 커널 하나를 함께 쓰고 있습니다.
그리고 그림 속 Docker Engine 층은 마치 앱과 OS 사이에 끼어서 무언가를 중계하는 것처럼 보이지만, 실제로는 그렇지 않습니다. Docker는 컨테이너를 띄워주는 역할만 하고, 실행이 시작되면 그 경로에서 빠집니다.
컨테이너 안의 프로그램은 Docker를 거치지 않고 호스트 커널에 직접 요청합니다.
그렇다면 컨테이너는 가상화라고 부를 수 있을까요? 여기서 스스로에게 재밌는 질문을 하나 던져보겠습니다.
docker run 한 번에, 또는 Pod 하나가 뜰 때 실제로 어떤 프로세스들이 지나가고, 커널은 뭘 요청받을까?
이 물음에 대한 답을 하기 위해서 알아야 하는 사실은 요청이 왔을때 커널이 받는 요청은 "컨테이너 만들어줘"가 아니라는 조금은 허탈한(?) 사실이 있습니다.
실제론 clone, unshare, mount, pivot_root, execve 같은 평범한 시스템 콜의 묶음을 요청합니다.
각 시스템 콜이 뭔지는 아직 몰라도 괜찮습니다. 중요한 건 컨테이너가 이 시스템 콜들의 결과물이라는 점입니다.
결국 컨테이너는 시야가 좁아진 평범한 프로세스일 뿐입니다.
자 그럼 이제 이 Docker라는 친구의 숨겨진 비밀과 우리가 몰랐던 불편한 진실까지 알아보겠습니다.
『비밀 1』컨테이너에는 커널이 없다
먼저 앞에서 말한 "컨테이너는 호스트의 커널을 함께 쓴다"는 말이 진짜인지 확인해보겠습니다.
참고로 저는 윈도우에서 이 글을 쓰고 있습니다. 윈도우의 Docker Desktop에서 아래 명령어를 실행해보면 재밌는 결과가 나옵니다.
docker run --rm alpine uname -r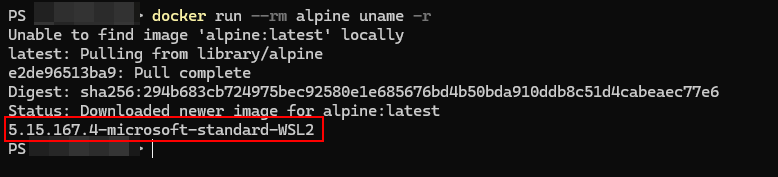
윈도우에서 실행했는데 윈도우가 아니라 리눅스 커널 버전이 나옵니다!
컨테이너는 커널을 따로 갖고 있지 않기 때문에, 리눅스 컨테이너를 돌리려면 반드시 리눅스 커널이 필요합니다.
그래서 Docker Desktop 설치할때 항상 설치 화면에서 WSL을 활성화 하고 설치하라는 문구가 떴던 겁니다ㅋㅋ
어찌보면 윈도우에서 도커를 돌리는 것이 OS설계적으로 잘 맞지 않을 수도 있다는 불편한 마음이 생기게 되는....불편한 진실이 있습니다.
리눅스 서버에서도 확인해보겠습니다. 홈랩 노드에서 호스트와 컨테이너의 커널 버전을 비교해봤습니다.
uname -r
docker run --rm alpine uname -r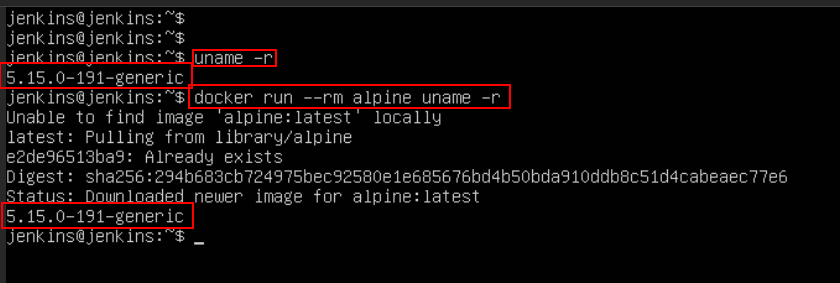
alpine 이미지로 띄운 컨테이너인데도 커널 버전은 호스트와 완전히 같습니다.
이걸 통해 알 수 있는 사실은 이미지에는 커널이 들어있지 않습니다.
이미지에 들어있는 건 alpine의 파일들인 라이브러리, 바이너리, 설정 파일뿐이고, 그 파일들을 실행하는 건 호스트의 커널입니다.
『비밀 2』호스트에서 보면 그냥 프로세스다
이번엔 컨테이너를 하나 띄워두고, 호스트에서 그 컨테이너를 바라보겠습니다.
docker run -d --name step1 alpine sleep 1000
ps -ef | grep "sleep 1000" | grep -v grep
호스트의 ps에서 컨테이너 안의 sleep 1000이 그대로 보입니다.
VM이었다면 호스트에서 VM 안의 프로세스는 절대 보이지 않습니다.
VM 안의 프로세스는 게스트 커널이 관리하고, 호스트 입장에서 VM은 그냥 하나의 큰 프로세스일 뿐이니까요.
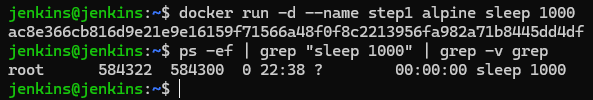
호스트의 ps에서 컨테이너 안의 sleep 1000이 그대로 보이는 신기한 광경이 펼쳐집니다 ㅋㅋ
VM이었다면 호스트에서 VM 안의 프로세스는 절대 보이지 않죠!
VM 안의 프로세스는 게스트 커널이 관리하고, 호스트 입장에서 VM은 그냥 하나의 큰 프로세스(QEMU 등)일 뿐이니까요.
그럼 이 프로세스의 부모는 누구일까요?
pstree -p -s $(pgrep -f "sleep 1000")
부모가 Docker Engine(dockerd)이 아니라 containerd-shim이라는 프로세스입니다.
앞에서 Docker는 띄워주는 역할만 하고 실행 경로에서 빠진다고 했던 게 바로 이 모습입니다.
그렇다면 그 사이에서는 어떤 일이 벌어졌는지 순서대로 보겠습니다.
잠깐, 시스템 콜이 뭔데요?
리눅스에서 프로그램은 두 개의 공간으로 나뉘어 동작합니다.
- User Space: 우리가 실행하는 프로그램(nginx, java, docker, runc 등)이 도는 공간
- Kernel Space: 커널이 도는 공간. 메모리, 디스크, 네트워크 같은 하드웨어 자원을 직접 다룹니다.
User Space의 프로그램은 하드웨어에 직접 손댈 수 없습니다.
파일 하나를 읽으려 해도 커널에게 "이 파일 좀 읽어줘"라고 부탁해야 합니다.
이 부탁하는 창구가 바로 시스템 콜 영어로 쓰면 System Call이라고 하죠.
프로그램과 커널 사이의 유일한 공식 창구라고 보면 됩니다.
정말 그런지, cat으로 파일 하나 읽을 때 무슨 일이 일어나는지 strace로 엿보겠습니다.
strace -e trace=openat,read,write cat /etc/hostname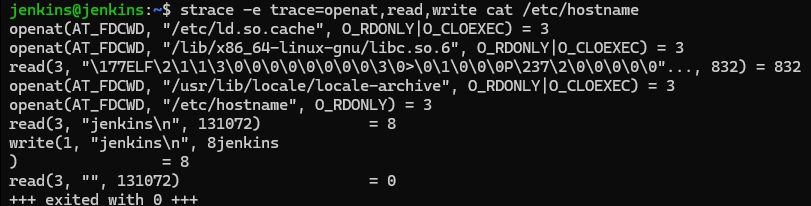
openat으로 파일을 열어달라고 부탁하고, read로 내용을 읽어달라고 부탁하고, write로 화면에 출력해달라고 부탁합니다.
cat 같은 단순한 명령어조차 혼자서는 아무것도 못 하고 전부 커널에 부탁하고 있습니다.
컨테이너도 마찬가지입니다.
kubelet이든 containerd든 runc든 전부 User Space 프로그램이라서 결국 시스템 콜로 바뀌어야 동작을 합니다.
runc를 씹고 뜯고 맛보고 즐겨보자
이제 runc가 컨테이너를 만들 때 커널에 무엇을 부탁하는지 직접 보겠습니다. Docker를 거치지 않고 runc만 단독으로 실행해보겠습니다.
먼저 runc가 쓸 재료인 번들을 준비합시다.
번들은 컨테이너의 루트 파일시스템인 rootfs와 설정 파일인 config.json로 이루어져 있습니다.
mkdir -p ~/lab/bundle/rootfs && cd ~/lab/bundle
docker export $(docker create alpine) | tar -C rootfs -xf -
runc spec
jq '.process.args=["sleep","30"] | .process.terminal=false' config.json > c && mv c config.json
그리고 runc가 컨테이너를 만드는 동안 호출하는 시스템 콜을 기록합니다.
sudo strace -f -o trace.log \
  -e trace=clone,clone3,unshare,setns,pivot_root,mount,sethostname,execve \
  runc run demo
grep -E 'unshare|clone\(|pivot_root|sethostname|execve' trace.log
앞에서 말한 시스템 콜이 전부 등장합니다!
순서대로 보겠습니다.
- execve("/proc/self/fd/6", ["runc", "init"]): runc가 자기 자신을 runc init이라는 모드로 다시 실행합니다.
(쉽게 설명하면 보안 취약점을 막기 위해 자기 바이너리의 복사본을 실행하는 방식입니다. 궁금하신 분은 클릭) - clone → 338번 프로세스: 새 프로세스를 하나 만듭니다.
- unshare(...): 338번이 "나는 이제부터 마운트(NS), 호스트네임(UTS), IPC, PID, 네트워크를 따로 쓰겠다"고 커널에 요청합니다. 컨테이너의 격리가 여기서 시작됩니다.
- 다시 clone → 339번 프로세스: 한 번 더 프로세스를 만듭니다.
(이게 이번 포스팅의 핵심 질문입니다. 바로 아래에서 다룹니다.) - pivot_root: 339번의 루트 경로를 준비한 rootfs로 바꿉니다. 이제 이 프로세스에겐 alpine의 파일들만 보입니다.
- sethostname: UTS 네임스페이스가 분리됐으니 호스트에 영향 없이 자기만의 호스트네임을 가집니다.
- execve("/bin/sleep"): 마지막으로 339번 프로세스가 sleep으로 변신합니다. 이 순간부터 runc의 흔적은 사라지고, 이 프로세스가 곧 컨테이너입니다.
왜 clone을 두 번 할까?
여기서 이상한 점이 하나 있습니다. 338번이 이미 unshare로 격리를 마쳤는데, 왜 굳이 339번을 또 만들까요?
이유는 unshare(CLONE_NEWPID)의 특이한 동작 때문입니다.
PID 네임스페이스를 새로 만들어도 호출한 프로세스 자신은 새 네임스페이스로 들어가지 않습니다.
새 네임스페이스에는 그 다음에 만드는 자식부터 들어갑니다.
그래서 338번은 새 PID 네임스페이스를 만들기만 하고, 그 안에 들어갈 첫 번째 주민으로 339번을 낳습니다.
339번은 새 PID 네임스페이스의 첫 프로세스, 즉 PID 1이 됩니다. 컨테이너 안에서 ps를 치면 앱이 PID 1로 보이는 이유가 이것입니다.
그래서 System Call을 통해 커널단에 몇 번이나 부탁했을까?
시스템 콜별로 몇 번이나 호출됐는지 세보겠습니다.
for s in clone3 'clone(' unshare setns pivot_root 'mount(' sethostname execve; do
  printf "%-12s %s\n" "$s" "$(grep -c "$s" trace.log)"
done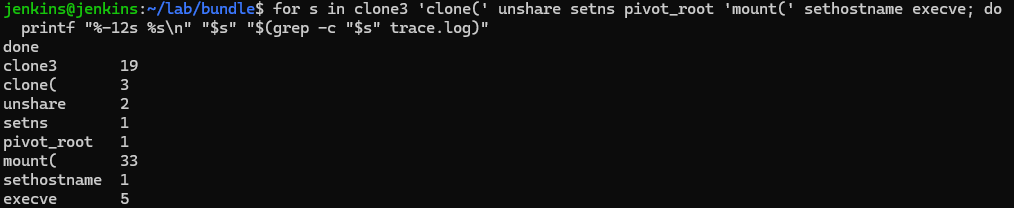
"컨테이너 만들어줘"라는 시스템 콜은 어디에도 없습니다.
프로세스를 만들고(clone), 시야를 가르고(unshare), 파일시스템을 갈아끼우고(mount, pivot_root), 프로그램을 바꿔 끼우는(execve) 평범한 시스템 콜 요청들의 조합일 뿐입니다.
쿠버네티스도 똑같을까?
Docker가 아니라 쿠버네티스의 Pod라면 다를까요? 홈랩 쿠버 노드에서 확인해보겠습니다.
쿠버네티스 노드의 containerd도 결국 runc로 컨테이너를 만들기 때문에, runc의 상태 디렉토리를 직접 조회할 수 있습니다.
sudo runc --root /run/containerd/runc/k8s.io list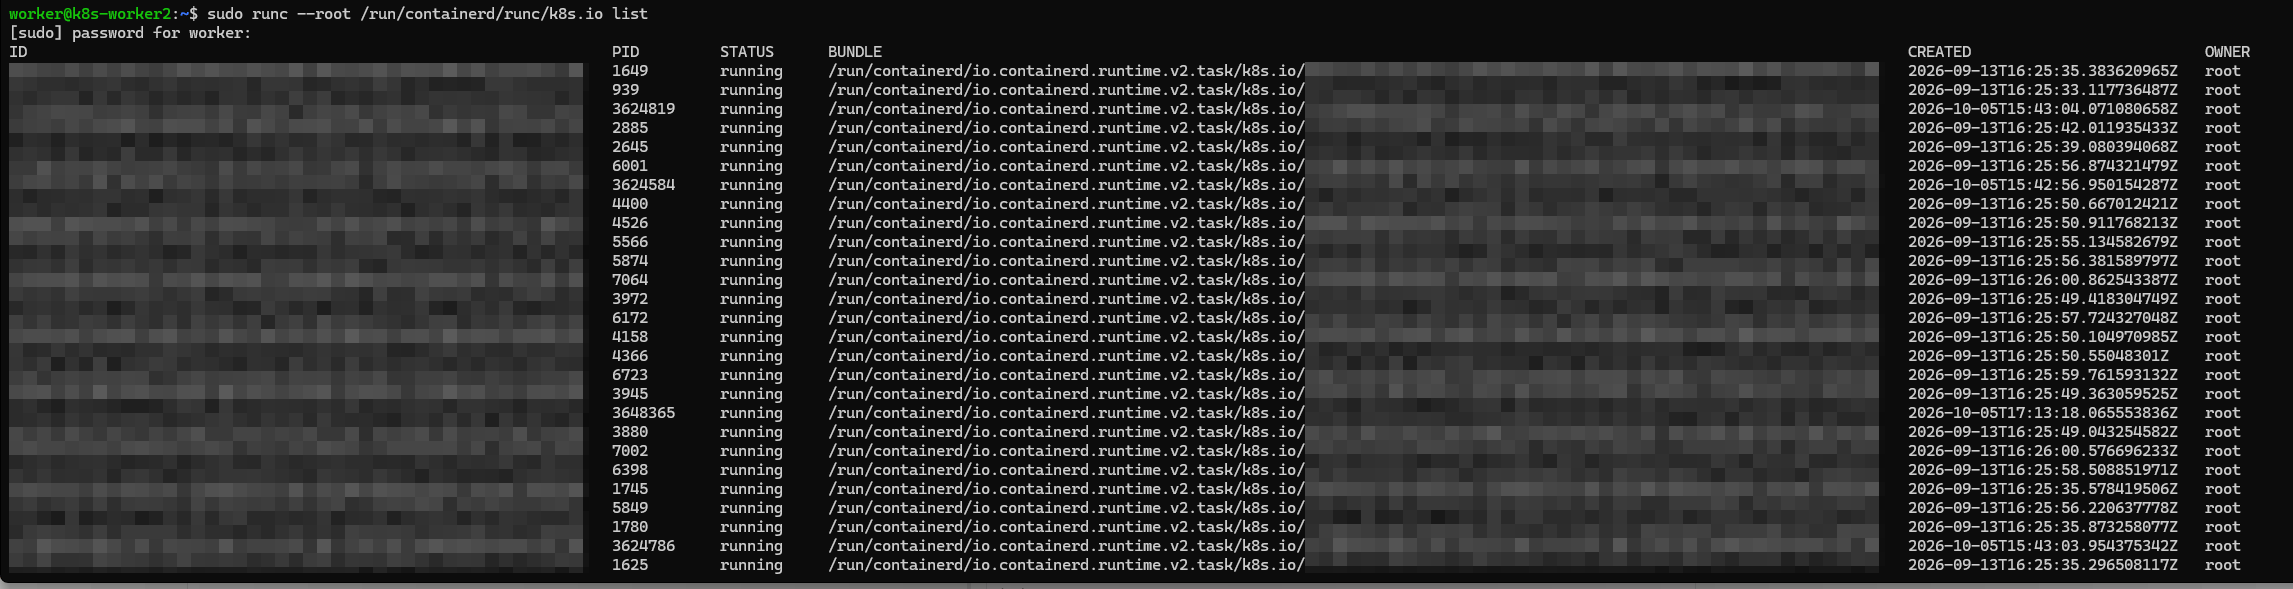
노드에 떠 있는 Pod의 컨테이너들이 runc의 컨테이너 목록에 그대로 나옵니다.
쿠버네티스의 Pod도 결국 runc가 만든 컨테이너, 즉 시스템 콜로 시야를 좁힌 프로세스들입니다.
마치며
처음 질문으로 돌아가 보겠습니다.
docker run 한 번에, 또는 Pod 하나가 뜰 때 실제로 어떤 프로세스들이 지나가고, 커널은 뭘 요청받을까?
이제는 답을 제대로 해볼 수 있죠!
- docker CLI → dockerd → containerd → containerd-shim → runc → runc init을 거쳐 최종 프로세스가 만들어지고, runc는 사라집니다.
- 커널이 받는 요청은 "컨테이너 만들어줘"가 아니라 clone, unshare, mount, pivot_root, execve 같은 평범한 시스템 콜들입니다.
- 그렇게 만들어진 컨테이너는 호스트의 커널을 그대로 쓰는, 시야가 좁아진 평범한 프로세스입니다.
그래서 컨테이너는 엄밀히 말하면 가상화라기보다 격리에 가깝습니다.
VM이 커널까지 통째로 따로 두는 방식이라면, 컨테이너는 같은 커널 위에서 보이는 것만 나누는 방식입니다.
그럼 그 시야는 정확히 어떻게 좁혀지는 걸까요?
다음 글에서는 Docker도 runc도 쓰지 않고, 오직 unshare와 pivot_root만으로 컨테이너를 직접 손으로 만들어보겠습니다.